怎样在 Mac 上用 AI 阅读长篇 PDF,而不用把它粘贴进聊天窗口?
简单说,别把 PDF 搬到 AI 那里,而是把 AI 放到 PDF 旁边。在 Mac 上用阅读器打开文件,阅读实际页面,再针对眼前的段落提问。答案依据这段文字,而不是模型对书名的模糊记忆。
听起来差别很小,日常使用却完全不同。这也是大家反复提出类似问题的原因:
“你平时怎么筛选学术论文?”——Ask HN
“Ask HN:截至 2017 年,最好的 PDF/学术论文阅读器是什么?”——Ask HN
相隔九年,问题依然没解决:阅读和思考被分在不同的应用里。
为什么把 PDF 粘进聊天窗口会出问题
页面不见了。 聊天界面把 300 页文档变成一串摘录。你无法再指着页面问问题。“解释一下这个”也失去了意义,因为眼前已经没有“这个”。
版面不见了。 多数工具会先把 PDF 拍平为纯文本。双栏论文会交错,表格变成一长串文字,图注也可能和图隔着好几段。之后再问表格,模型拿到的表格可能已经乱了。
你分不清文本内容和模型记忆。 这是代价最大的问题。问到知名论文或书籍时,通用助手可能完全不看你的文件,只根据训练资料给出听起来合理的答案。两种答案语气一样,你无从分辨。
每次都得从头开始。 昨天解释过的内容、你已经理解的概念、不得不让它解释三遍的地方,下一次全都不在了。
“AI PDF 阅读器”应该具备什么
按重要程度排列,有四点:
- PDF 还是 PDF。 保留原始固定版面、真实页面和页码,栏、表格、图注都在作者放置的位置。
- AI 以文本为依据。 它说文档写了什么时,能指出原文;使用一般知识时,也会明确说明,而不是把两者混在一起。
- 你可以直接指向内容。 选中一句话,就针对这句话提问。
- 理解可以延续。 上周弄懂的内容应该影响这周的解释。
Resage 围绕这四点设计:它是一个全页 Mac 阅读器,底部有讨论栏;只有你需要时,讨论栏才出现。
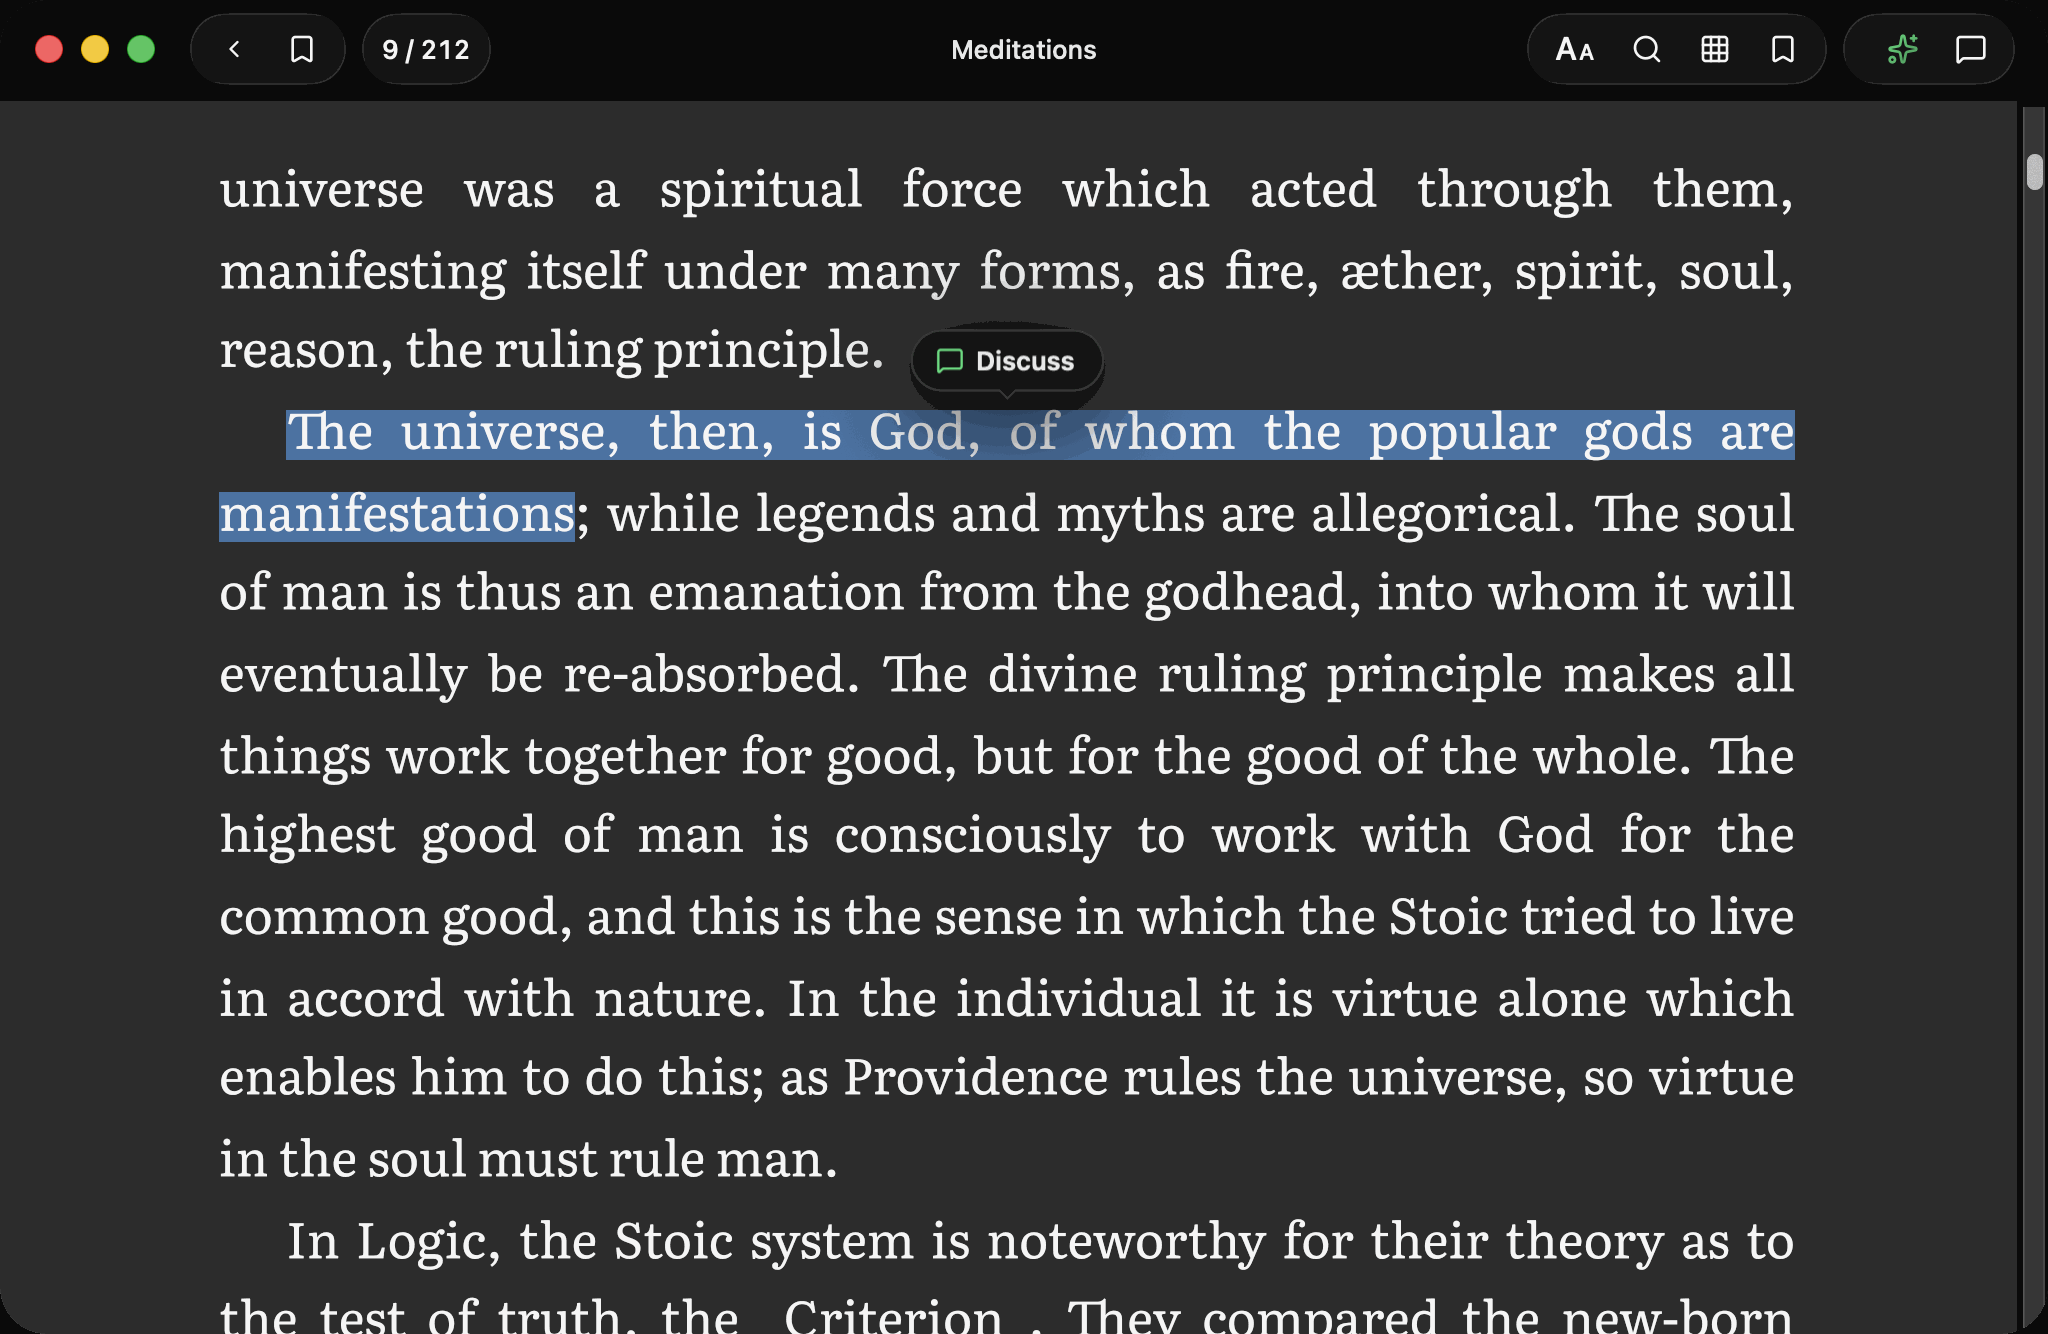
实际阅读论文时
导入文件。 支持 PDF、EPUB、Word、TXT、Markdown 和无 DRM 的 Kindle 文件(MOBI、AZW3)。把文件拖到书库里即可。
阅读实际页面。 PDF 按原始版面显示,不会在你不知情时被重排成纯文本。
围绕当前段落提问。 选中一句话后会出现“讨论”按钮。问题会附上这段原文,因此回答依据你的文本,而不是模型对摘要的半记忆。
需要通读全文时,运行一次云端通读。 同意 AI 数据处理后,Resage 会在云端准备新导入的文件。完成后,你可以从任意页面提问整份文件,例如“方法部分在哪里与引言矛盾”。扫描页也会在此过程中识别,无需额外设置。
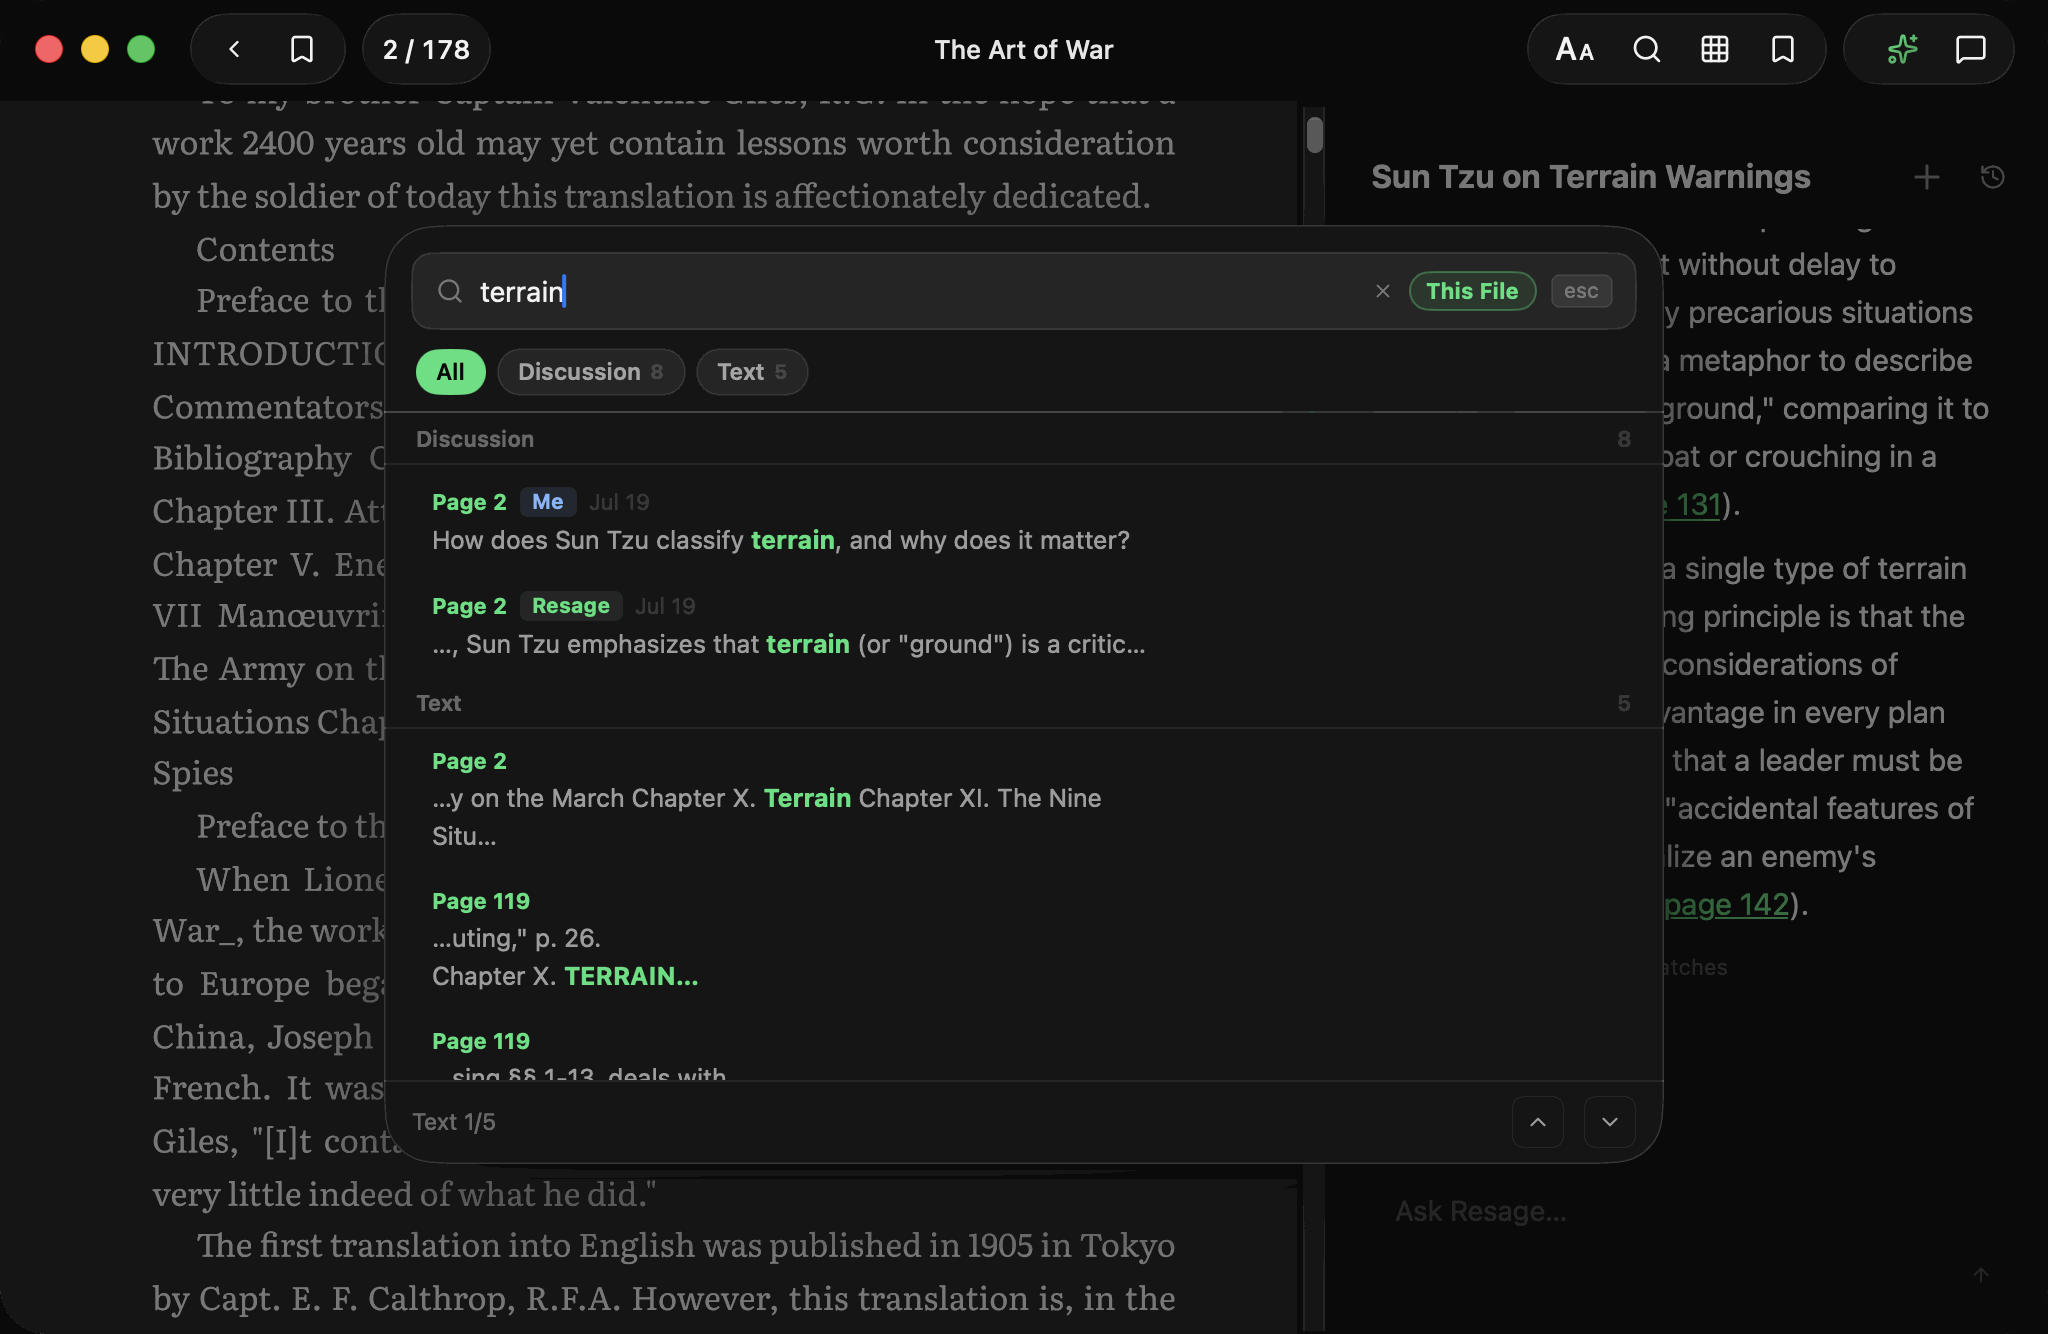
同时搜索正文和过去的讨论。 搜索的不只是某个词出现在哪里,也包括你曾经在哪里讨论过它。
功能边界
下载前最好先了解这些限制:
- 目前只有 Mac 版本。 需要 Apple Silicon 和 macOS 14.0 或更高版本。尚无 Windows、Android 或网页版本。
- 不是 PDF 编辑器。 不能合并、涂黑、填写表单或移除水印。
- 不是文献管理器。 不替代 Zotero,也不维护引用文献库。
- 不是笔记库。 没有高亮导出或 Obsidian 同步。它保存的是对话记忆,不是一堆摘录。
- 讨论需要联网。 下载的书可以离线阅读。云端通读和文字识别需要同意 AI 数据处理并连接互联网。回答由云端模型生成。
- 无法打开受 DRM 保护的文件。 任何第三方阅读器都无法打开这类文件,Resage 也一样。
哪些内容会离开你的 Mac
你同意 AI 数据处理后,新导入的书会在 Mac、iPhone 和 iPad 上进行云端准备;处理完成后会删除临时上传的原件。不同意时,阅读使用轻量本地解析,不会上传文件进行云端准备。AI 回答会用到相关段落,你的内容不会用于训练模型。
有一个例外需要说清楚:如果你问的是必须“看”而不是读的图、示意图或表格,Resage 可能会发送该页的单页图像供模型查看。
常见问题
我能针对整份 PDF 提问吗,还是只能问当前页面?
完成云端通读后可以。你同意 AI 数据处理后,Resage 会先在云端准备新导入的文件;之后可以从任意页面提问整份文件。通读前,回答会以你当前看的段落为依据。
PDF 会保留原始版面吗?
会。PDF 按原始固定版面显示,不会重排成纯文本,因此栏、表格和图注仍在作者放置的位置。
这和把 PDF 上传到 ChatGPT 有什么不同?
实际使用中有两点差别:你可以继续阅读真正的页面,而不是滚动浏览提取出的引文;阅读器可以跨文件保留阅读讨论和简短 AI 笔记,而不是每次从零开始。更详细的比较见Resage 与 ChatGPT。
它能处理没有文本层的扫描 PDF 吗?
可以。同意 AI 数据处理后,扫描页会在云端通读过程中识别。请看识别如何工作以及何时会失败。
费用是多少?
可以免费开始,每月有讨论额度。阅读不按次数收费;云端通读(包括扫描件识别)使用云端处理额度。Resage Plus 每月 4.99 美元或每年 39.99 美元,并提供更多讨论额度。