怎样向没有文本层的扫描 PDF 提问?
如果在 PDF 中按 ⌘F 却什么也找不到,这个文件就没有文本层。每一页都是图像,软件无法读取其中的文字。AI 工具要回答文件内容问题,必须先把图像转换成文字。
常见建议是先用 OCR 工具处理文件,再把结果放到其他地方。这样能用,但几乎没人会一直这样做:最后得到一份看起来不像原书的文本文件,以及一本和文本无法对应的书。
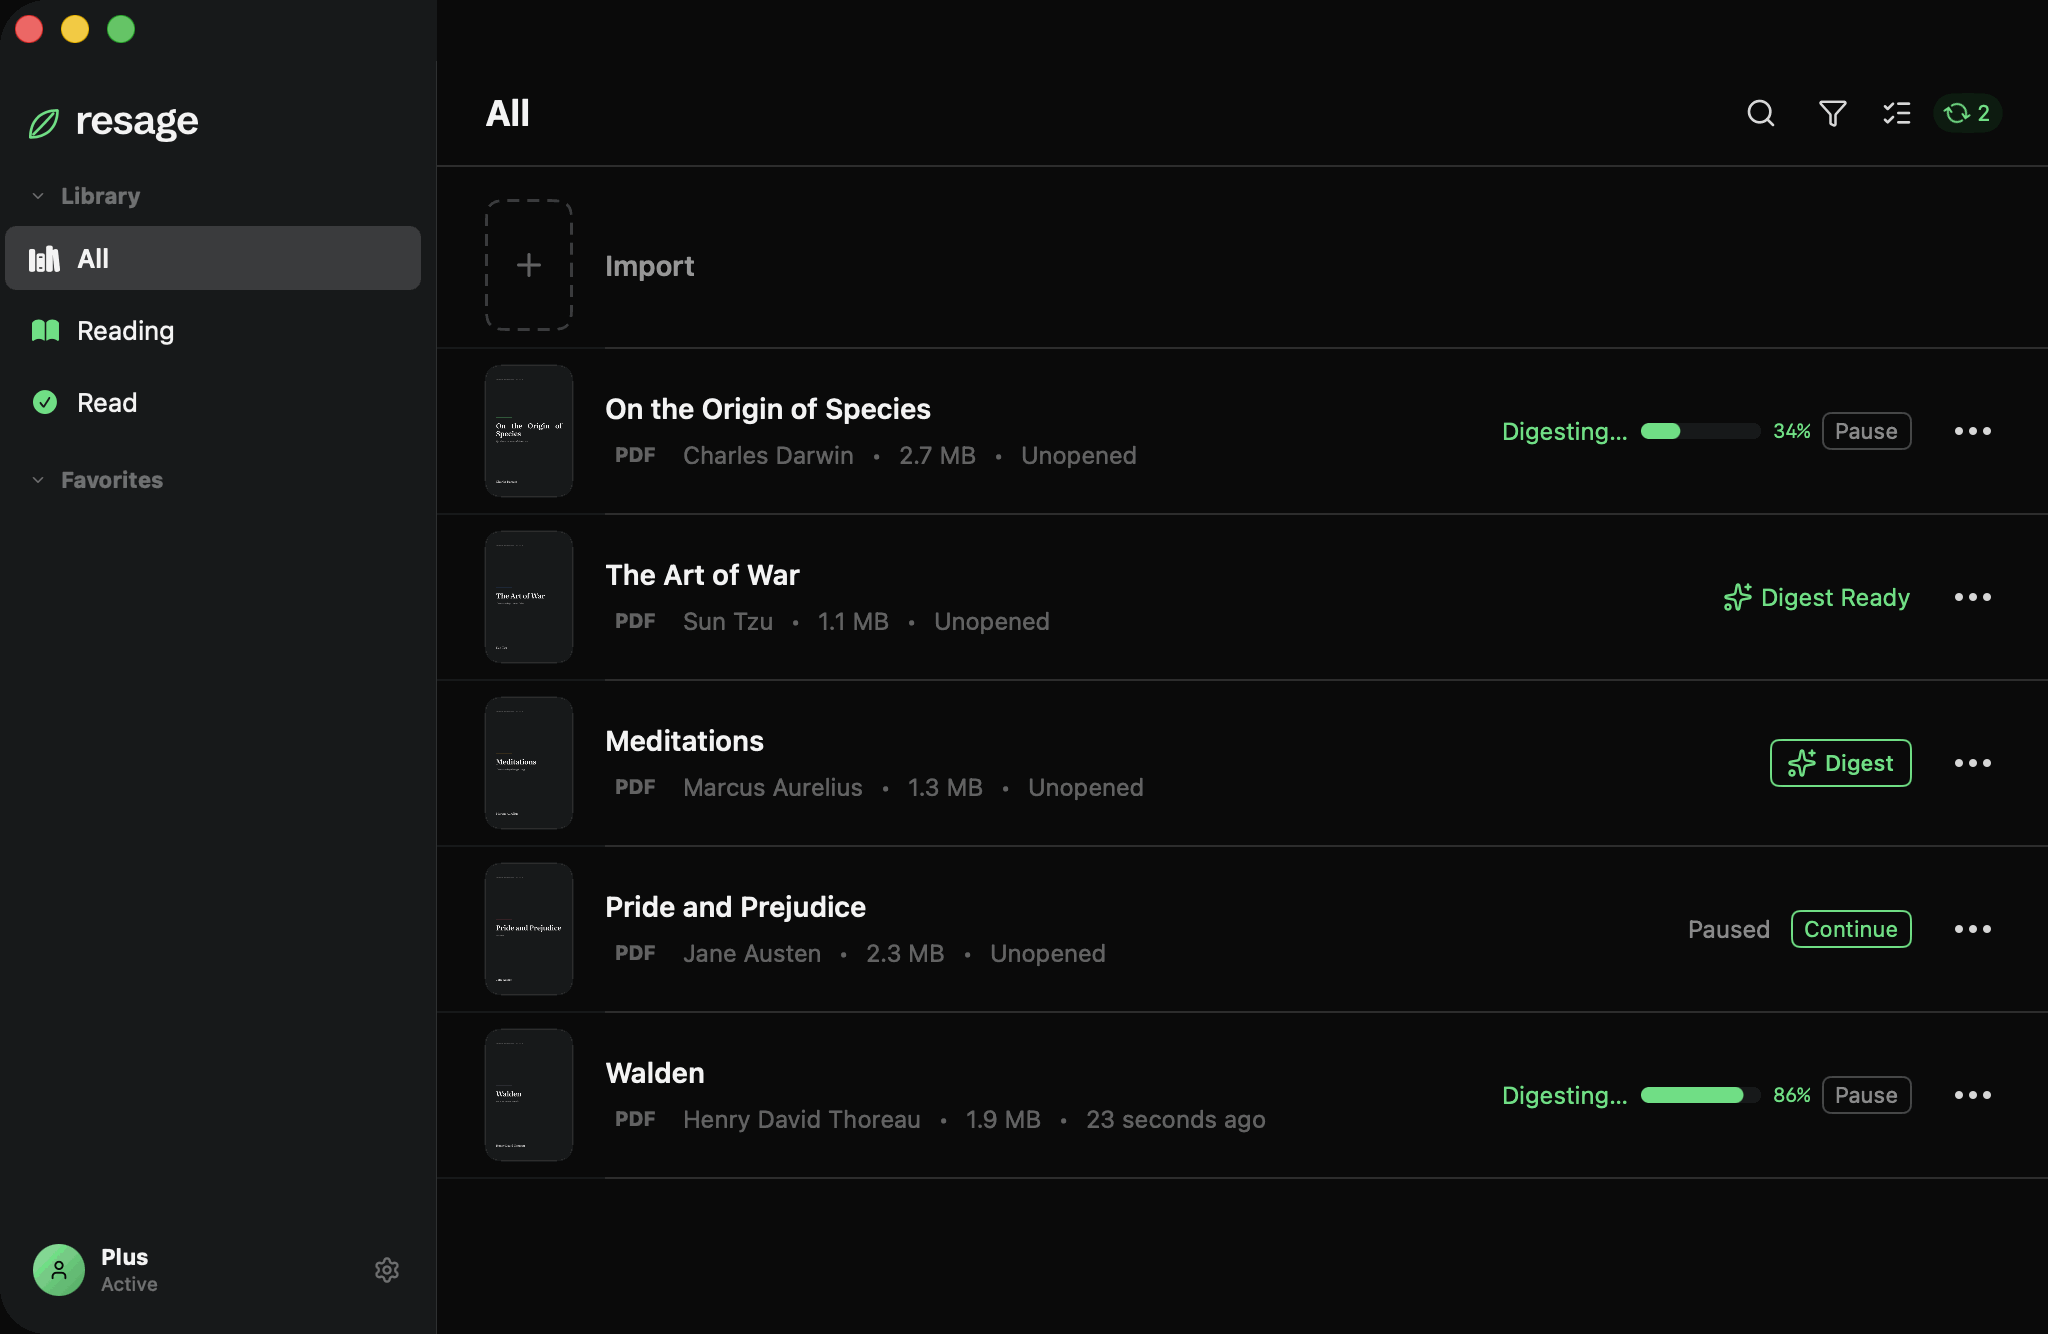
同意 AI 数据处理后,云端准备会在你继续阅读原始扫描件的同时识别页面。
这类问题经常以类似的形式出现:
“有人找到真正好用、能一次从多张图片提取文字的方法吗?”——r/PDF
“Ask HN:怎样对 PDF 做 OCR 并保留空白?”——Ask HN
很少有人提醒你的陷阱
扫描文件没有文本层时,通用 AI 助手仍然会回答你的问题,但它依据的是对书名的记忆,而不是你的文件。听起来和根据页面回答的语气完全一样。
遇到热门书籍时,它可能给出另一版本的摘要:页码不同,有时连译文也不同,偶尔还会编出手中这本书里没有的情节。遇到扫描手稿或旧报告时,得到的就是自信的虚构内容。
所以真正的要求不是“它能不能 OCR”,而是:它能不能区分自己是在读你的页面,还是在回忆书名,并且会不会告诉你刚才用的是哪一种?
Resage 怎样处理扫描件
在云端通读时识别。 Resage 阅读文件时,会逐页识别没有可用文字的页面。不需要单独做 OCR、设置选项或排队处理。
同意 AI 数据处理后在云端运行。 扫描页在云端准备时识别。任务完成后会删除临时上传的原件;若无法完成,则在七天后删除。
逐页检测语言。 不必维护一份语言清单,识别功能会自动检测。目前的 macOS 大约支持三十种语言,包括中文、日文、韩文、西里尔文字、阿拉伯文、泰文、越南文以及十六种拉丁字母的欧洲语言。法文和日文扫描件走同一处理流程。
还原分栏阅读顺序。 识别出的文本框会组合为行并排序;系统会检测双栏页面,先读完一栏再读另一栏,而不是在中间来回跳读。
通读完成后,扫描件就像其他书一样。 可以搜索,也可以针对整份文档提问;回答会标出来源页码。
我们测量了什么,识别失败时怎么办
多数工具不会说明这部分。识别结果可能几乎为空:页面拍摄角度不佳、印章和批注太多,或文字体系无法识别。如果系统不说明情况,你可能会觉得 AI 很笨,实际却是它没有可用内容。
Resage 会检查识别结果,并说明问题。以下两个阈值来自我们自己的测试:
- 每页平均少于 100 个字符,或有文字的页面少于总页数的 60%,就会将此次处理判为失败,而不是显示已完成。
- 识别失败时,会再通过另一项测量判断应告知哪种失败。竖排文字会产生又高又窄的文本框,横排文字则不会。在我们的测试文件中,横排书籍的窄文本框占 0.00%,竖排古籍为 33% 到 50%。识别阈值设在 15%,与两组结果都有明显区分。
因此:竖排扫描件是已知限制,不是未知问题。 导入这类文件时,系统会告诉你文字是竖排的、无法正确读取,而不是默默继续并给出一堆打乱的字符。
这些测量不保证你的特定文件一定能成功。清晰的 300 dpi 印刷页扫描件通常很好处理;光线不足、阴影中的手机拍照结果可能很不稳定;十九世纪的手写账本则不适用。
功能边界
- 支持 Mac、iPhone 和 iPad。 Mac 需要 Apple Silicon 和 macOS 14.0 或更高版本;iPhone 和 iPad 需要 iOS 17 或更高版本。暂无 Windows、Android 或网页版。
- 不是 OCR 产品。 不能将识别出的文字导出为可搜索 PDF,没有批量转换流程或编辑功能。
- 不支持竖排文字。 限制如上所测。
- 不处理手写内容。
- 第三方阅读器都无法打开受 DRM 保护的文件。 Resage 也一样。
- 长文件的云端通读需要时间。 同意 AI 数据处理后在云端运行;处理期间可以继续阅读。
常见问题
扫描页会上传进行识别吗?
你同意 AI 数据处理后,新导入的书会在 Mac、iPhone 和 iPad 上进行云端准备;处理完成后会删除临时上传的原件。不同意时,阅读使用轻量本地解析,不会上传文件进行云端准备。提问时会把相关段落发送给 AI 服务提供方;涉及图像的问题还可能发送单页图像。
我怎么知道回答来自扫描内容还是模型的一般知识?
Resage 会说明。如果回答依据一般知识而不是你的文本,会明确标出;声称书里写了什么时,会附上对应段落。
文件识别失败时会怎样?
系统会告诉你失败原因:文字似乎是竖排,或页面内容无法读取。不会悄悄继续,然后临时编造答案。
它能识别哪些语言?
语言会自动检测。目前的 macOS 大约支持三十种,包括中文、日文、韩文、西里尔文字、阿拉伯文、泰文、越南文和主要的拉丁字母欧洲语言。已知不支持竖排文字。
文字识别需要付费吗?
不需要按次付费。阅读不计量;云端通读(包括扫描件识别)使用云端处理额度。免费版每月有讨论额度;Resage Plus(每月 4.99 美元,每年 39.99 美元)会提高讨论额度。